AIに書かせた社内メールに、「いつもお世話になっております」と入っていました。宛先は上司です。
自分は社内でこの挨拶を使いません。というより、言えません。 社外の相手に使う言葉だと思っているので、部長宛てのメールに書くのは、どうにも落ち着かないんですよね。
このメールを書いたのは、ネットの向こうにあるAIではありません。手元のMacBook Airの中で動いているAIです。
なぜそんなものを試したかというと、普段使っているAIが止まるからです。
この記事で分かること
- メモリ16GBのMacBook Airで、ローカルAIは動くのか。何分待つのか
- 入れる前に、どこで詰まるのか
- 速度も出来も問題なかったのに、結局使わなかった理由
制限 ── ClaudeもCodexも、5時間で両方いっぺんに止まる
普段は Claude Code と Codex を使っています。ブログの記事を書くのも、案件の応募文を作るのも、この2つです。
どちらにも5時間の利用制限があります。使いすぎると止まって、しばらく待たされます。
困るのは、両方いっぺんに止まることです。片方が止まってももう片方へ逃げられればいいんですが、同じように使っているので、だいたい同じ頃に両方とも上限に来ます。そうなると、その日はもう手が止まります。
そこで、手持ちのMacの中で動くAIを試してみることにしました。パソコンの中で動くなら、利用制限はありません。
ただ、それが自分のやり方の中でどう収まるのかは、正直まだ見えていませんでした。 何を任せられて何を任せられないのか、やってみないと分からない。分からないから試す、という感じですね。
使ったのは、いま主力にしている M4のMacBook Air、メモリは16GB です。ソフトは LM Studio を選びました。無料で、Macで動いて、モデルを選んで入れられるものです。
「制限がない」というのは、クラウドの利用枠を待たずに動かせるという意味です。パソコンのメモリや速度、モデルの賢さまで無制限になるわけではありません。
容量 ── 入れる前に、内蔵の空きが14GBしかなかった
さっそく詰まりました。ソフトを入れる前の段階です。
内蔵ストレージの空きを見たら、228GBのうち14GBしか残っていませんでした。 93%使っています。
何が食っているのか調べました。
| 場所 | 使っている量 |
|---|---|
| アプリケーション | 36GB |
| アプリが作ったデータ(Application Support) | 35GB |
| システムのライブラリ | 18GB |
| キャッシュ | 7.5GB |
| ダウンロード | 2.3GB |
すぐ消せそうなのはキャッシュの7.5GBくらいで、片手間では空きません。
一方、必要な容量はこれくらいです。
- LM Studio本体:1.6GB(インストーラは543MB)
- AIのモデル:1本で6〜8GB
入りません。 正確には1本なら入りますが、空きが数GBになります。Macは空きが少ないと動きが不安定になるので、そこまで攻めたくはありませんでした。
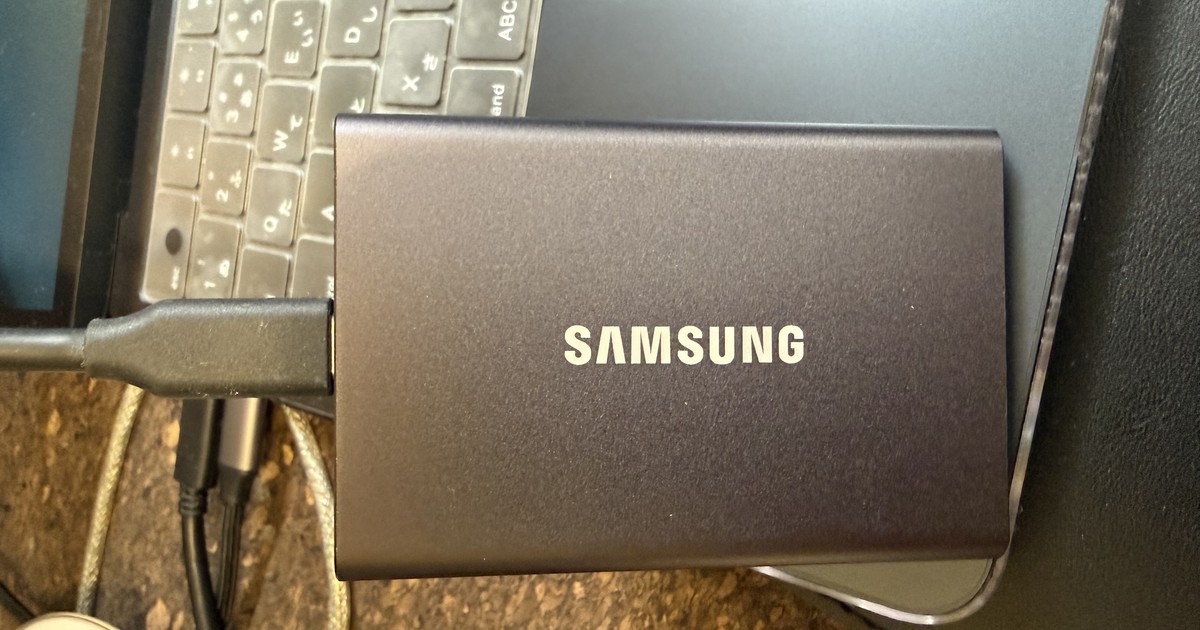
そこで、外付けのSSD(Samsung T7・1TB)にモデルを置くことにしました。LM Studioは保存先を変えられます。
このT7は前から作業フォルダとして使っているもので、今回のために買ったわけではありません。空きは886GBありました。
ここで気になったのが速度です。外付け経由だと遅くなるんじゃないか。ただT7はSSDなので、そんなに遅くはならないはずだとは思っていました。
測りました。同じモデル(8.07GB)を読み込む時間です。
| 置き場所 | 1回目 | 2回目 | 3回目 | 中央値 |
|---|---|---|---|---|
| 外付け T7 | 22.9秒 | 17.0秒 | 16.8秒 | 17.0秒 |
| 内蔵SSD | 11.2秒 | 12.2秒 | 10.5秒 | 11.2秒 |
差は5.8秒でした。
8GBを内蔵から追い出して、代償が6秒弱。これなら外付けでいいと思います。 ちなみにT7へのコピーは8.07GBが19.8秒だったので、ディスク自体はかなり速いものです。
ただし、T7を外すとローカルAIは使えません。 外に持ち出したMacBook Air単体では動かない、ということです。そこは割り切りですね。
内蔵の空きを増やしたいなら、モデルを外付けSSDに置く方法もあります。今回使ったのは、前から持っていたSamsung T7・1TBです。
沈黙 ── 1本目のモデルは、5分47秒かけて何も言わなかった
モデルを選びます。ここで選定を外しました。
最初に入れたのは Qwen3.5 9B です。日本語が扱えると聞いていたので選びました。ダウンロードは5.98GBで25分25秒。
3つの仕事を渡しました。要約、メモの整理、メールの下書きです。
結果です。
| 渡したもの | かかった時間 | 返ってきた答え |
|---|---|---|
| 記事の要約 | 227.0秒 | 0字 |
| メモの整理 | 257.4秒 | 0字 |
| メールの下書き | 259.4秒 | 0字 |
3つとも、答えが返ってきませんでした。
原因は分かりました。このモデルは考えてから答えるタイプで、考えた中身と答えが別々に出てきます。考えている途中で上限に達して、答えに移らないまま終わっていました。
念のため、いちばん簡単な問題を出してみました。
「猫が屋根で寝ている」を英語にしてください。
出力の上限を3,000トークンまで広げて、待ちました。
347.3秒 ── 5分47秒かけて、答えは0字でした。 考えた中身を見ると、英語で「主語は猫」「動作は寝ている」と分解している途中で終わっています。
考えるのをやめさせる方法を3通り試しましたが、どれも効きませんでした。
- 指示の末尾に `/no_think` を付ける
- API に `chat_template_kwargs: {“enable_thinking”: false}` を渡す
- API に `reasoning_effort: “low”` を渡す
3つとも、生成された語はすべて「考えている中身」に消えました。
ここで言えるのは「このモデルとこの環境の組み合わせでは、答えが返らなかった」ということだけです。ローカルAIが全部だめ、という話にはなりません。モデルを1つ外しただけかもしれないので、別のものを試しました。
2本目は Gemma 3 12B。考えてから答えるタイプではないものを選びました。8.07GBで、ダウンロードは9分50秒です。
同じ回線なのに、1本目は25分25秒、2本目は9分50秒でした。倍以上ちがいます。 時間帯か配信元の差だと思いますが、片方だけ見て「導入に25分かかる」と考えると外します。
誤算 ── 「7分かかる」は、1回しか測っていない数字だった
Gemmaは答えを返しました。ただ、最初に測った要約の時間が 443.7秒(7分24秒) でした。
7分は長い。この時点では「待って使うのは無理だな」と思っていました。
念のため測り直しました。同じ文章、同じ指示、同じ設定です。
| かかった時間 | |
|---|---|
| 最初の測定 | 443.7秒 |
| 測り直し 1回目 | 58.3秒 |
| 測り直し 2回目 | 22.1秒 |
20倍ちがいました。
443.7秒だけが飛び抜けています。モデルを読み込んだ直後の一発目だったので、そのあたりが原因かなとは思うんですが、はっきりとは分かりません。
読み込み時間でも同じことが起きていました。いちばん最初は42.8秒でしたが、あらためて3回測ると17秒前後です。最初に出た数字だけで、使い勝手を決めようとしていたわけです。
1回の数字で決めると外します。 これは自分への戒めでもあります。
及第 ── 要約・メモ整理・メール下書き、3つとも通った
あらためて3つの仕事を渡しました。比べるために、普段使っているAIにも同じ文章と同じ指示を渡しています。
要約に使ったのは、自分が前に書いた壊れたLinkStationからデータを取り出した記事です。中身を知っている文章の方が、要約が合っているか判断しやすいので選びました。
| 渡したもの | 元の長さ | かかった時間 | 返ってきた長さ |
|---|---|---|---|
| 記事の要約 | 5,594字 | 58.3秒 | 461字 |
| メモの整理 | 797字 | 61.0秒 | 473字 |
| メールの下書き | 921字 | 64.3秒 | 597字 |
だいたい1分です。
出来はどうか。3つとも、切り口は違うけれど全然いけると思いました。 普段のAIと比べると違いはありますが、使えないという感じではありません。
メモの整理は、どちらもそのまま使えます。散らかった箇条書きに見出しを付けて分類しただけですが、内容を勝手に足したりもしていません。
要約は、少し引っかかりました。返ってきた文にこう書いてあります。
ローカルAIの要約から
まず、RAIDミラーリングで安心していた筆者は、本体が故障するとデータにアクセスできなくなります。
(中略)
今回の経験を通して、データを取り出せることと無料で読めることは別物であり、AIとの連携でエンジニア知識がなくてもデータの救出は可能であると学びました。
「筆者は」「学びました」。なんだか国語の授業みたいだなと思いました。
内容そのものは合っています。RAIDはバックアップではなかったという、その記事のいちばん痛いところも外していません。
自分としては、スパッと文字数を詰める方向に行ってほしかったんですよね。でも「要約」と言われたら、こういう形になるものなのかもしれません。国語の勉強が得意ではなかったので、これが正しいのかどうか、結論は出しづらいです。
ただ、ひとつ言えるのは、AIは指示どおりに「要約」をしたということです。ずれていたのは、自分が「要約」という言葉に何を期待していたか、の方でした。
まとめて渡すとどうなるか
1本1分なら、まとめて渡せるんじゃないか。記事を3本、続けて要約させてみました。
| 記事 | 長さ | かかった時間 |
|---|---|---|
| 1本目 | 5,201字 | 99.7秒 |
| 2本目 | 3,055字 | 96.5秒 |
| 3本目 | 6,000字 | 139.3秒 |
| 合計 | 337.2秒(5.6分) |
3本で5.6分でした。寝る前に渡して翌朝、というほど待つ必要はありません。
ただし、今回の設定では12,218字の記事はそのまま入りませんでした。 一度に扱える量は 6,912トークン(AIが文章を数える単位)。前半6,000字に切って渡しています。
圧迫 ── 動かしている間、他の作業が止まる
作業をしていて、パソコンが重くなるのを感じました。これは仕方ないのか、と思って測りました。
| 空きメモリ | メモリからあふれた量 | |
|---|---|---|
| モデルを載せているとき | 35% | 8,847MB |
| 降ろしたあと | 63% | 5,167MB |
モデルを降ろすだけで、空きメモリがほぼ倍になりました。あふれた量も3.6GB減っています。
16GBのうち7.5GBを1つのモデルが占めるので、残りでmacOSもブラウザも動かすことになります。気のせいではありませんでした。
打てる手はあります。LM Studioには「しばらく使わなかったら自動で降ろす」設定があり、最初は1時間になっていました。これを10分に変えました。うっかり載せっぱなしにして重いまま、ということがなくなります。
もっとも、いちばん効くのは使う時間を分けることです。日中は降ろしておいて、まとめて渡したいときだけ載せる。そうすれば、他の作業とぶつかりません。
ただし、実際にメールを1通書かせただけのときは、重さは感じませんでした。 軽い作業なら気にならない、ということだと思います。「感じない」ことと「メモリを食っていない」ことは別ですね。
言葉 ── 使えるのに、選んだのは自分の言葉の方
ここまで、設定も測定もコマンドで進めていました。自分では画面をほとんど見ていません。 動いているのは分かるけれど、どう動いているのかは見えない。
それで、最後に自分で触ってみました。LM Studioを開いて、モデルを選んで、質問を1つ。
「明日の会議に出られなくなったことを、上司に伝えるメールを書いて」
読み込みは17秒くらい。それくらいなら、まあいいかなと思います。 文字が出てくる速さも、別に遅いとは思いませんでした。
返ってきたのが、この画面です。
ローカルAIが書いたメール(抜粋)
件名:明日の会議欠席のご連絡
〇〇部長
いつもお世話になっております。
明日〇月〇日(〇)に予定されている[会議名]につきまして、誠に申し訳ございませんが、急な所用により欠席させていただきたくご連絡いたしました。
(中略)
私分として何かお手伝いできることがございましたら、遠慮なくお申し付けください。
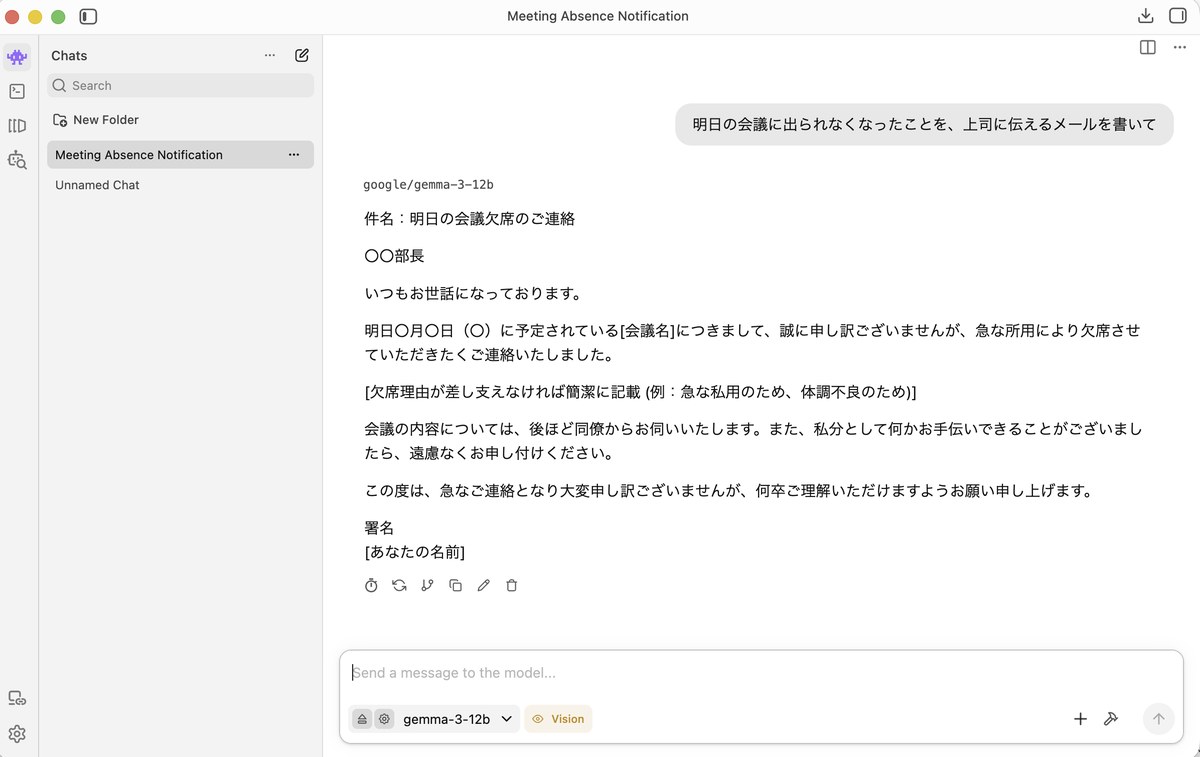
体裁は整っています。件名があり、`〇〇部長`や`[会議名]`と埋める場所を空けてあり、欠席理由も「差し支えなければ」と添えてある。16GBのMacBook Airが、これを1分かからずに書いています。
でも、送れません。
「いつもお世話になっております」を、社内の上司には使わないからです。 これは社外の相手に使う挨拶で、自分は社内では絶対に使いません。嫌いですし、言えない。
もうひとつ、「お申し付けください」。これも自分は使いません。
面白いのは、この「お申し付けください」がさっきのメール下書きの実験でも出ていたことです。まったく別の場面で、2回とも同じ言い回しが出てきました。たまたまではなく、このモデルの癖なんだと思います。
つまりこういうことです。
- 速度は問題ない。17秒待って、1分で返ってくる
- 出来も問題ない。3つとも及第点
- それでも、自分の言葉ではない
賢さが足りないのではありません。日本語も正しいし、ビジネスメールの形にもなっている。でも、自分が書く文章にはならない。
そして、これはローカルAIだけの話ではありません。 前に、普段使っているAIに応募資料を作らせたとき、自分が言った覚えのない「連絡は当日中を目安に返信します」が入っていました。夜勤が入る週は、まず守れません。大きいAIでも、同じことをします。
試す前は、これが自分のやり方の中でどう収まるのか、まったく見えていませんでした。
やってみて分かったのは、動くかどうかで悩む必要はなかったということです。16GBのMacBook Airで普通に動きましたし、1分待てば返ってきます。詰まったのは、AIの賢さではなくディスクの空きでした。
そのうえで、普段のAIを使い続けると思います。 理由は速さでも賢さでもなくて、返ってくる文章が自分の言葉に近いかどうかです。直す手間が少ない方を選ぶ、というだけの話ですね。
ただ、下書きを作らせて自分で直すなら、ローカルでも十分だとも思っています。どのみち「お世話になっております」は消すわけですから。
今回分かったこと
- メモリ16GBのMacBook Airで動きました。 記事1本の要約が1分前後、3本まとめても5.6分です
- 詰まったのはAIではなく、ディスクの空きでした。内蔵に14GBしか残っておらず、外付けSSDへ逃がしています
- 外付けに置いた代償は、読み込みが5.8秒延びるだけでした(内蔵11.2秒/外付け17.0秒)。ただし外付けを抜くと使えません
- モデルによっては、答えが返ってきません。 1本目は簡単な英訳に5分47秒かけて0字でした
- 1回だけ測った数字で決めると外します。 同じ処理が443.7秒と22.1秒、約20倍ちがいました
- 載せている間はメモリを食います(空き63%→35%)。使わないときに自動で降ろす設定にしました
- 今回の設定では、12,218字の記事はそのまま入りませんでした(一度に扱える量は6,912トークン)
- 出来は及第点。それでも普段のAIを選びました。 賢さではなく、言葉の問題です
コメント